
if ( !emtpy($headline_subheadline ) ) : ?>
Vous ne pouvez pas demander à un compte de service compromis s’il s’agissait bien de lui. Voici comment repenser la réponse aux incidents pour les identités des machines.
endif; ?>
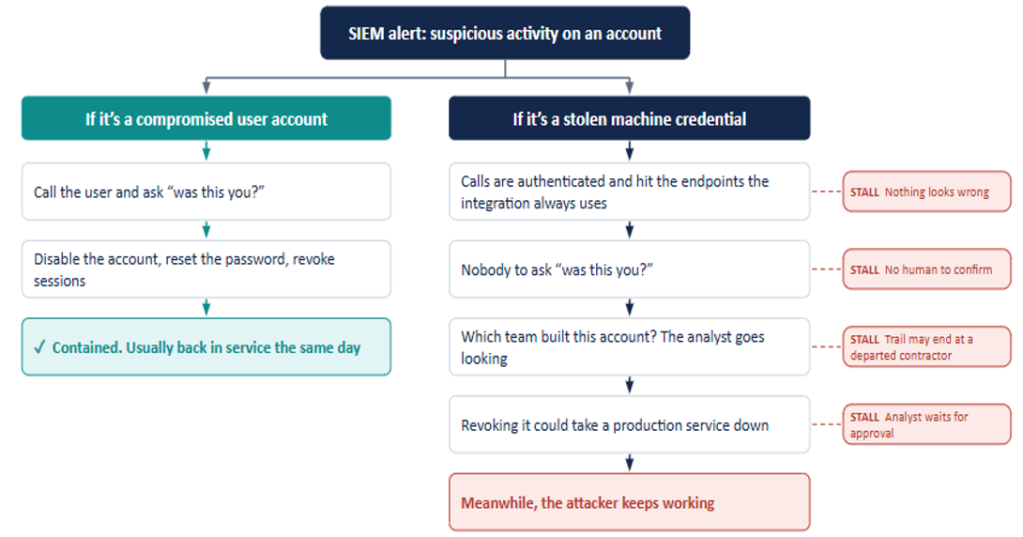
Affichez le playbook du compte compromis de votre SOC et lisez les 15 premières minutes. La plupart des SOC commencent leur réponse en appelant ou en envoyant un message à l’utilisateur via Teams pour lui demander si la connexion à 2 heures du matin depuis un pays inconnu était bien lui. Leurs actions ultérieures dépendent de la réponse de l’utilisateur.
Essayez cela avec un compte de service et vous attendrez longtemps. Il en va de même pour une clé API enfouie dans un pipeline de construction ou un jeton OAuth accordé à une intégration SaaS en 2022 et auquel on n’a pas pensé depuis. Une fois l’un d’entre eux volé, vos analystes exécutent un script qui a été écrit en pensant aux personnes, et les fissures ont tendance à apparaître bien avant le premier transfert de poste.
Ils sont également bien plus nombreux que la plupart des conseils d’administration ne le pensent. Les recherches de CyberArk évaluent le nombre d’identités de machines à environ 82 pour chaque identité humaine. Très peu de personnes siègent derrière MFA, et un bon nombre d’entre elles bénéficient d’un accès bien supérieur à celui pour lequel elles ont été créées. J’ajouterais un problème qui nécessite moins de temps d’antenne, à savoir que leur trafic vit dans le bruit de fond que votre surveillance a été réglée pour filtrer.
Là où le manuel de jeu humain s’arrête
La propriété est généralement la première chose qui vous ralentit. Lorsque le compte d’une personne est compromis, les RH peuvent vous dire qui elle est et qui est son responsable avant que vous ayez fini votre café. Un compte de service extrayant des données qui ne devraient pas être accompagnés d’un tel raccourci, l’analyste passe donc la première heure à déterminer quelle équipe l’a construit. Plus souvent que quiconque ne veut l’admettre, cette piste se termine chez un entrepreneur qui a quitté l’entreprise un an plus tôt.
Supposons que vous trouviez un propriétaire ; le confinement n’est toujours pas l’étape propre qu’il est pour une personne. Verrouillez un utilisateur et un employé perd un après-midi. Cependant, retirez les informations d’identification dont dépend une intégration de paiements et vous pourriez supprimer un service destiné aux clients, qu’aucun analyste ne veut voir sur son nom à 23 heures sans signature. Ils partent donc à la recherche d’une personne suffisamment haut placée pour approuver la panne pendant que l’attaquant continue.
La détection est la partie que les gens sous-estiment. Un attaquant disposant d’un jeton valide effectue des appels authentifiés vers les mêmes points de terminaison que l’intégration atteint chaque jour, et un patient respectera même ses horaires habituels. Vos règles de voyage impossible ont été construites autour des personnes se déplaçant entre les villes, elles n’ont donc rien à comparer ici.
Ce que montrent les récentes violations
La description par Cloudflare de son incident de sécurité survenu lors de Thanksgiving 2023 vaut un quart d’heure du temps de tout RSSI. Les attaquants sont arrivés avec un jeton d’accès et trois identifiants de compte de service supprimés lors de la précédente violation du support Okta. Cloudflare avait alterné des milliers d’identifiants après Okta, mais avait manqué ces quatre car l’équipe pensait, à tort, que rien ne les utilisait. L’alerte qui a finalement été déclenchée est survenue plus d’une semaine après la première connexion des attaquants, lorsqu’ils ont ajouté l’un de ces comptes de service à un groupe d’administrateurs.
Le cas de Microsoft concernait une application de test que personne n’avait nettoyée. Ses conseils destinés aux intervenants lors de l’attaque de Midnight Blizzard décrivent une pulvérisation de mot de passe sur un ancien compte de locataire de test sans MFA. À l’intérieur de ce locataire se trouvait une ancienne application de test OAuth qui disposait toujours d’un accès élevé à l’environnement de l’entreprise, et les attaquants l’ont utilisée pour accéder aux comptes de messagerie de l’entreprise.
La dérive est le cas que je mettrais devant une planche. En août 2025, des attaquants ont mis la main sur les jetons OAuth que le chatbot Drift de Salesloft utilisait pour communiquer avec Salesforce, et pendant environ dix jours, ils ont extrait les enregistrements des instances Salesforce d’un client après l’autre. L’équipe de renseignement sur les menaces de Google, qui a suivi la campagne de près, a conclu que les attaquants recherchaient principalement des informations d’identification. Une fois les données disponibles, ils les ont fouillés à la recherche de clés d’accès et de mots de passe AWS, tout ce qui pourrait les amener à entrer dans la prochaine entreprise.
Je ne pense pas qu’aucun des trois ait besoin d’un attaquant intelligent à la porte d’entrée. Dans chaque cas, une attestation était délivrée pour un travail, puis laissée tranquille longtemps après la fin du travail.
Commencer par préparer le terrain
C’est une tâche relativement simple de créer un playbook. Cependant, un playbook repose sur un inventaire. Dans de nombreuses organisations, cet inventaire consiste en une liste de comptes de service générée à partir d’Active Directory dans laquelle la moitié des champs de description sont laissés vides. Chaque fois que vous identifiez une identité non humaine à haut privilège, documentez l’équipe responsable de cette identité et fournissez une brève explication (une ou deux phrases) décrivant ce qui échouera si vous supprimez cette identité. De nombreuses personnes n’expliquent pas pourquoi quelque chose échouerait s’il était supprimé, car l’obtention de ces informations nécessite de contacter l’équipe chargée de l’application pour obtenir des éclaircissements ; ce contact serait autrement initié par votre analyste à 3h00 du matin alors que l’attaquant reste actif au sein de votre réseau.
Ensuite, triez ces identités par rayon d’explosion. Je ne mettrais pas un jeton de rapport en lecture seule sur le même chemin de réponse qu’un principal de service d’administration cloud, et je doute que vos auditeurs le fassent non plus. Pour le niveau supérieur, déterminez à l’avance qui est autorisé à autoriser une révocation immédiate même si cela renverse quelque chose, et indiquez son nom dans le manuel de jeu. Les dirigeants doivent s’approprier cet appel. Si vous le laissez à quelqu’un qui est en poste, vous recevrez une attente polie pour obtenir la permission pendant que le jeton reste actif. Pour les entités réglementées par SOCI, cela présente un avantage supplémentaire, car la fenêtre de 12 heures pour signaler un cyber-incident important à ASD peut durer pendant que la conversation se prolonge.
Un tri adapté à une machine
Personne ne peut répondre à la question « était-ce vous ? » ; remplacez-la donc par des questions auxquelles les fichiers journaux peuvent répondre. Un moyen de vérification rapide est la localisation : d’où les informations d’identification se connectent-elles habituellement et d’où se connectent-elles actuellement ? La journalisation est facilement disponible via Cloud Audit Logs et Workload Identity Platforms, si quelqu’un a activé la journalisation.
Les autorisations prennent plus de temps mais vous en disent plus. Comparez ce que contient l’identité avec ce qu’elle a utilisé au cours des derniers mois, car les attaquants ont tendance à s’attaquer directement aux étendues à haut risque qui sont restées inactives. J’accorderais la même attention à la persévérance. Avec un principal de service privilégié en main, un attaquant crée souvent de nouveaux secrets ou enregistre sa propre application, et rien de tout cela ne disparaît lorsque vous révoquez les informations d’identification d’origine.
Confinement sans casser les affaires
Le « déclencheur » de la rotation et de la révocation doit être écrit séparément dans le playbook. La rotation serait appropriée lorsque vous êtes raisonnablement sûr que l’attaquant n’a pas dégénéré et que l’organisation ne peut pas se permettre de perdre l’intégration. La révocation est le choix évident si vous trouvez des preuves d’une attaque en cours ; cela sera suffisamment clair pour qu’il n’y ait pas de débat à minuit.
La préparation préalable de vos informations d’identification de remplacement rendra les révocations tolérables. Lorsque l’équipe propriétaire de l’application a déjà testé comment générer un nouvel identifiant, puis le stocker dans son système de gestion des secrets, la révocation des anciens identifiants peut vous coûter environ dix minutes d’arrêt au lieu d’être une interruption d’une journée complète. Demandez à l’équipe de s’entraîner à générer et à stocker de nouvelles informations d’identification pendant une semaine à faible trafic. Ne découvrez pas au milieu de l’incident que le runbook fait référence à un emplacement de coffre-fort qui a été renommé l’année dernière.
Cadrage et récupération
Pour comprendre toute la portée d’un incident, examinez la durée de vie complète des informations d’identification de la machine, et pas seulement la période suivant la génération de l’alerte. Étant donné que les machines peuvent ne pas être détectées comme étant compromises pendant plusieurs mois avant leur découverte, la première activité inhabituelle signalée ne sera probablement pas la première activité inhabituelle réalisée. Gardez également à l’esprit que la « dérive » est un excellent moyen de se rappeler à quelles informations l’identité a accès et si quelqu’un a placé des informations d’identification dans cette identité. Si tel est le cas, chaque ajout de secret vous obligera à ajouter une nouvelle rotation à votre liste.
La récupération consiste à résoudre la cause initiale du problème. Par exemple, si un secret statique a été compromis, déterminez si cette charge de travail peut utiliser des jetons de courte durée à l’aide de Workload Identity Federation ; ou peut-être qu’un jeton de courte durée peut être généré à la demande (Just-In-Time) et expirera automatiquement. La récupération est une tâche fastidieuse et peu sexy, et elle nécessite la plupart du temps le soutien financier d’une entité extérieure au Security Operations Center (SOC).
Avant de finaliser le playbook, effectuez une simulation sur table en présence des propriétaires d’applications ainsi que du Security Operations Center (SOC). Sélectionnez votre intégration avec le privilège le plus élevé et simulez un événement de vol de jeton (de la première alerte à la récupération). Au cours de la simulation, lorsqu’une décision doit être prise concernant qui approuve la révocation du jeton, et que la révocation du jeton perturbera la production, observez combien de temps il faut à l’équipe pour identifier qui doit donner cette approbation.